
Przepełnienie stosu to jeden z problemów, które mogą nam szczególnie napsuć krwi przy debugowaniu. Aplikacja zaczyna zachowywać się w nieprzewidywalny sposób, pojawiają się dziwne wartości zmiennych, losowe zawieszenia, a przyczyna może znajdować się zupełnie gdzie indziej niż miejsce wystąpienia błędu.
W systemach embedded problem jest szczególnie istotny. Mamy ograniczoną ilość pamięci RAM, co zwiększa ryzyko wystąpienia przepełnienia stosu. A program może korzystać z uszkodzonych danych do sterowania krytycznym sprzętem.
Na szczęście istnieją mechanizmy pozwalające wykrywać takie sytuacje. Część procesorów oferuje sprzętową ochronę pamięci, ale nawet bez niej możemy samodzielnie zaimplementować odpowiednie zabezpieczenia. I w profesjonalnych projektach praktycznie zawsze będziemy chcieli zastosować taką ochronę. Czasem wymuszają to na nas normy safety-critical a czasem nasze wewnętrzne wytyczne dotyczące jakości oprogramowania.
W tym artykule pokażę, jak działa przepełnienie stosu, jakie mamy możliwości ochrony i jak zaimplementować własny mechanizm wykrywania przepełnienia na mikrokontrolerze STM32. Wykorzystamy do tego skrypt GNU Linkera, niewielki fragment kodu C i modyfikację procedury startowej.
Na początek mała powtórka. A przy okazji omówienie mechanizmów, które wykorzystamy w naszej procedurze wykrywania przepełnienia stosu.
Jak działa stos?
Stos to region pamięci RAM wykorzystywany przez procesor do przechowywania tymczasowych danych. Są tam odkładane między innymi zmienne lokalne, argumenty i zwracane wartości funkcji, zawartość rejestrów CPU, czy adresy skoków powrotnych z funkcji. Stos to również nazwa struktury danych typu LIFO (Last In First Out). Czyli mówiąc obrazowo wrzucamy kolejne dane na stos, a potem zabieramy je z góry zaczynając od najnowszych.
Kiedy procesor wchodzi do funkcji, tworzy ramkę stosu (Stack Frame), czyli strukturę zawierającą dane umożliwiające procesorowi obsługę funkcji i powrót do funkcji wywołującej. Ramka stosu zawiera właśnie adres powrotny, wartości rejestrów itp.
Podczas działania funkcji procesor może odkładać na stos i zabierać z niego kolejne dane. Są one umieszczane w kolejnych komórkach pamięci. Może również wywoływać kolejne funkcje zawierające swoje ramki stosu i kolejne dane odkładane na stosie.
Procesor przechowuje aktualny adres wierzchołka stosu w rejestrze SP (Stack Pointer – Wskaźnik Stosu). Kiedy kolejne dane są zrzucane na stos – wskaźnik stosu jest zwiększany.
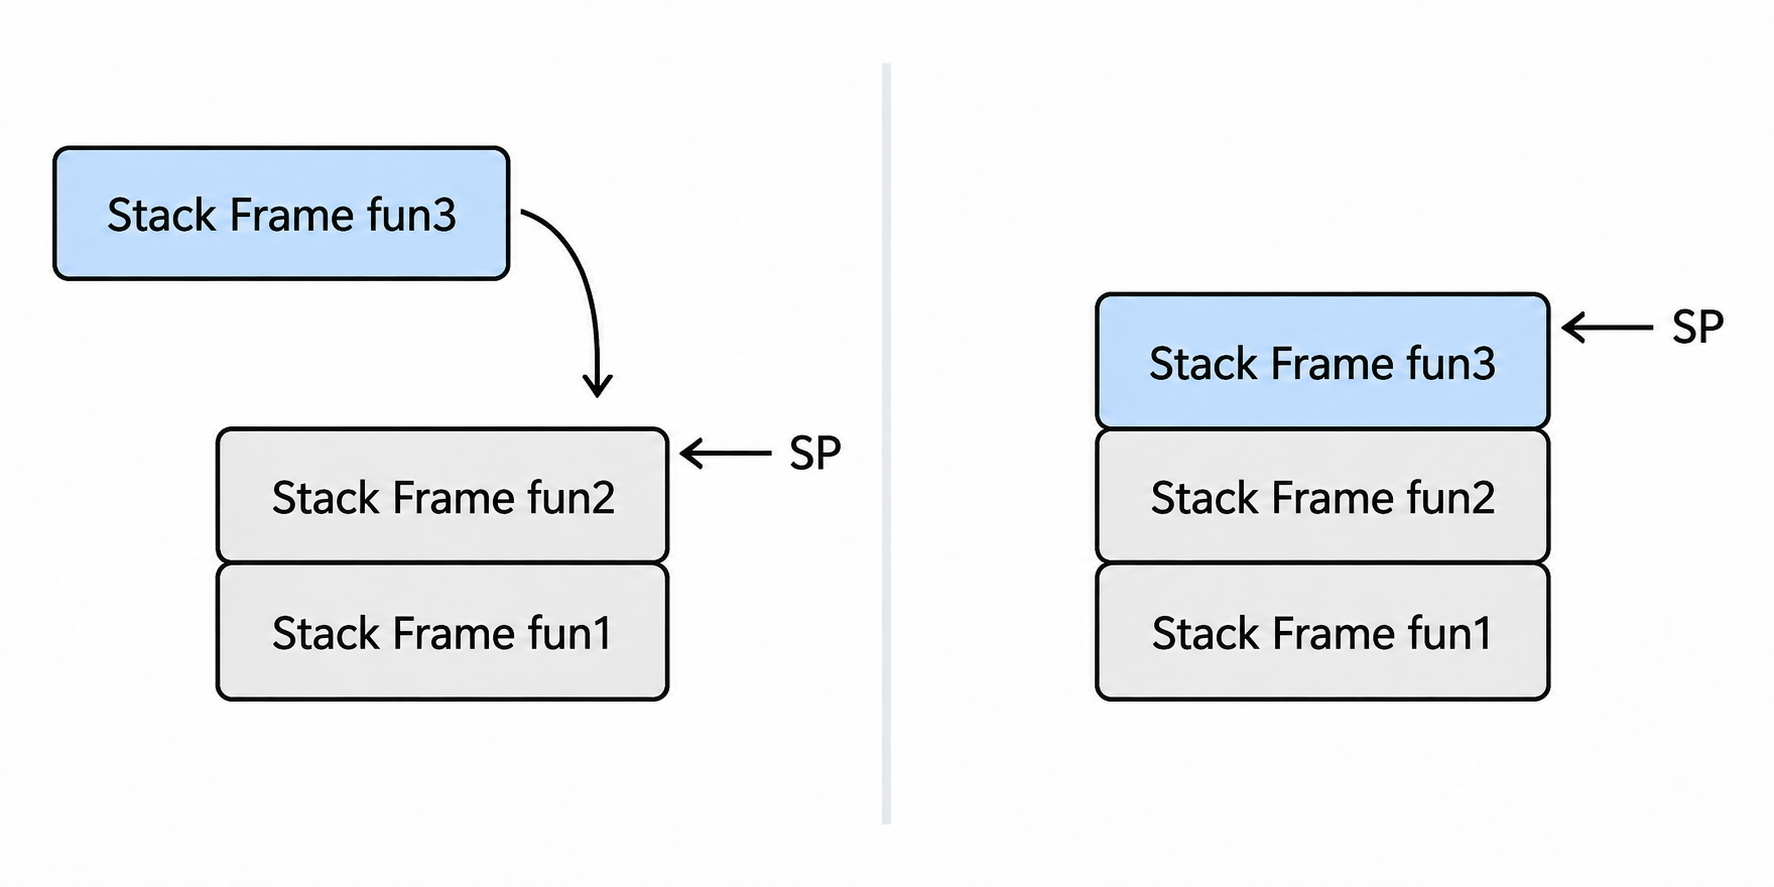
Jak widzisz – wywoływanie kolejnych funkcji powoduje odkładanie na stos coraz większej ilości danych.
Z kolei kiedy wartość jest ściągana ze stosu – wskaźnik stosu jest zmniejszany. Natomiast sama wartość dalej znajduje się w tej samej komórce pamięci. Po prostu nie jest już dłużej potrzebna, dlatego procesor o niej “zapomina”. A następnie może tam nadpisać kolejne dane.
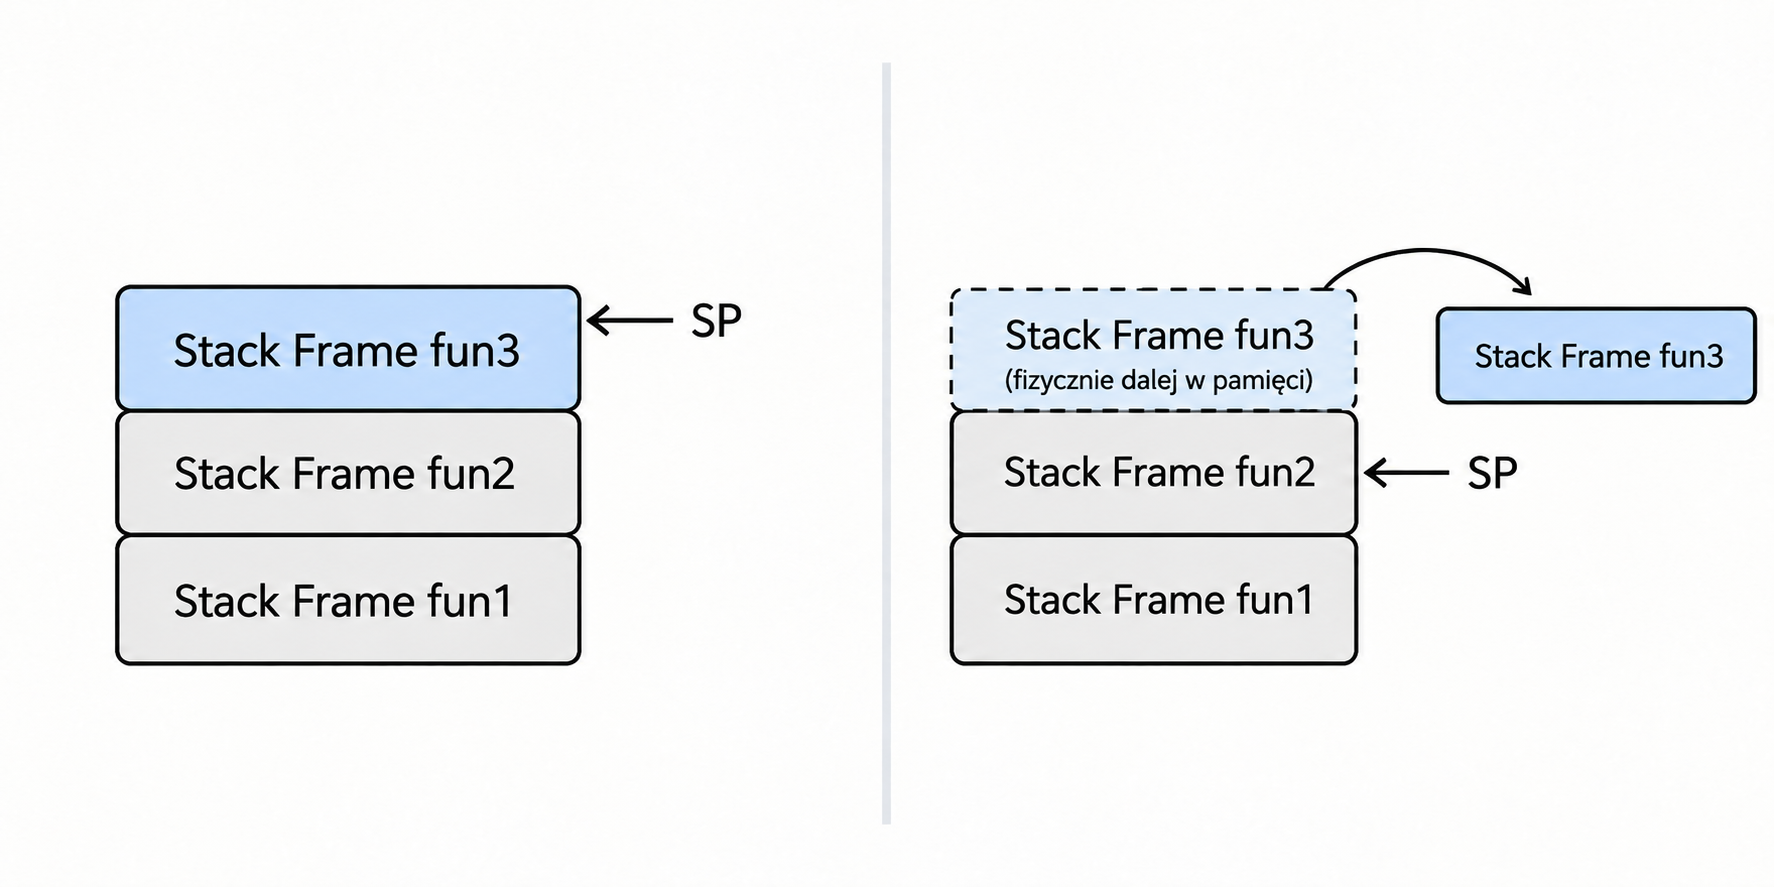
Czyli dane zapisane na stosie dalej siedzą w tych komórkach pamięci, nawet jeśli ich już nie używamy. Po prostu zostaną nadpisane jeżeli stos urośnie. Kiedy wywołamy wiele zagnieżdżonych funkcji, lub odłożymy na stos wiele danych – zużycie stosu znacząco się zwiększy. Potem kiedy wyjdziemy z tych zagnieżdżonych funkcji, wskaźnik stosu może już ponownie nie dotrzeć do tak wysokich wartości. Ale ślad w pamięci w postaci nadpisanych danych pozostaje
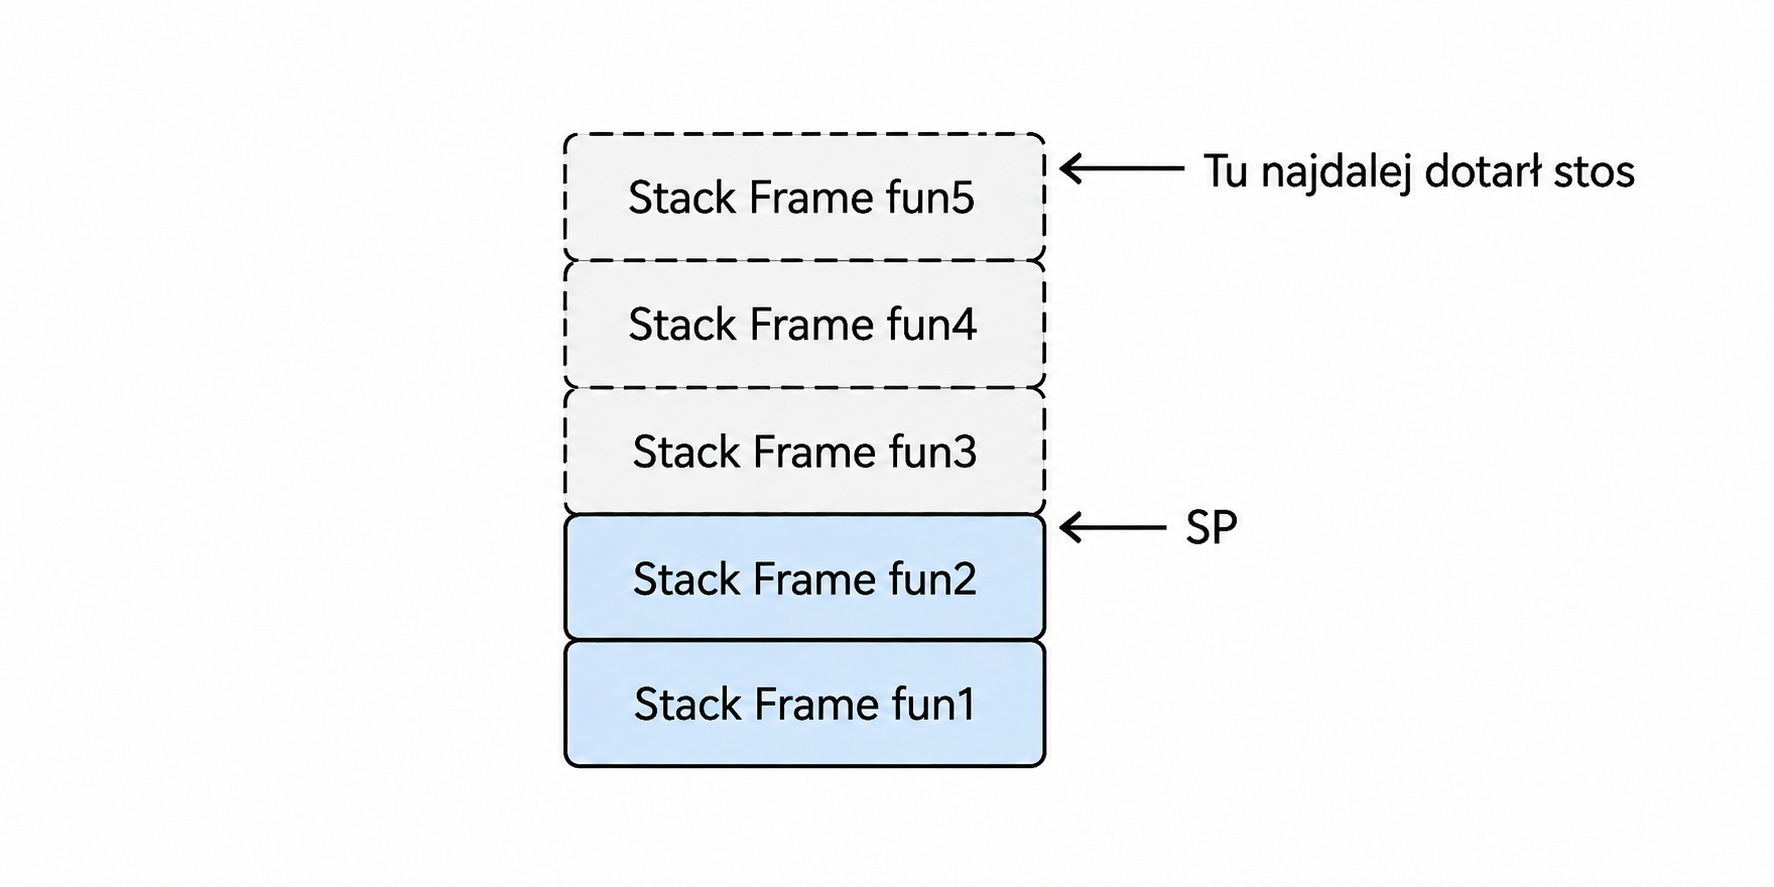
Możemy to porównać do rzeki, która nawet po obniżeniu swojego poziomu zostawia w korycie ślad po najwyższym poziomie wody. Dokładnie tak samo możemy obserwować maksymalne zużycie stosu. Ta metafora ma nieraz odwzorowanie w nazwie techniki programistycznej służącej do śledzenia zużycia stosu – Watermark, Water level.
Na czym polega przepełnienie stosu?
Stos najczęściej dzieli pamięć RAM z innymi danymi. W tym samym regionie RAM możemy mieć na przykład:
- Zmienne statyczne
- Stertę (Heap) do dynamicznej alokacji pamięci
- Specjalne sekcje użytkownika
- Kod wywoływany z RAM
Skrypt linkera nadzoruje sposób ułożenia tych sekcji we wspólnym regionie RAM. Ostatecznie możemy mieć na przykład coś takiego:
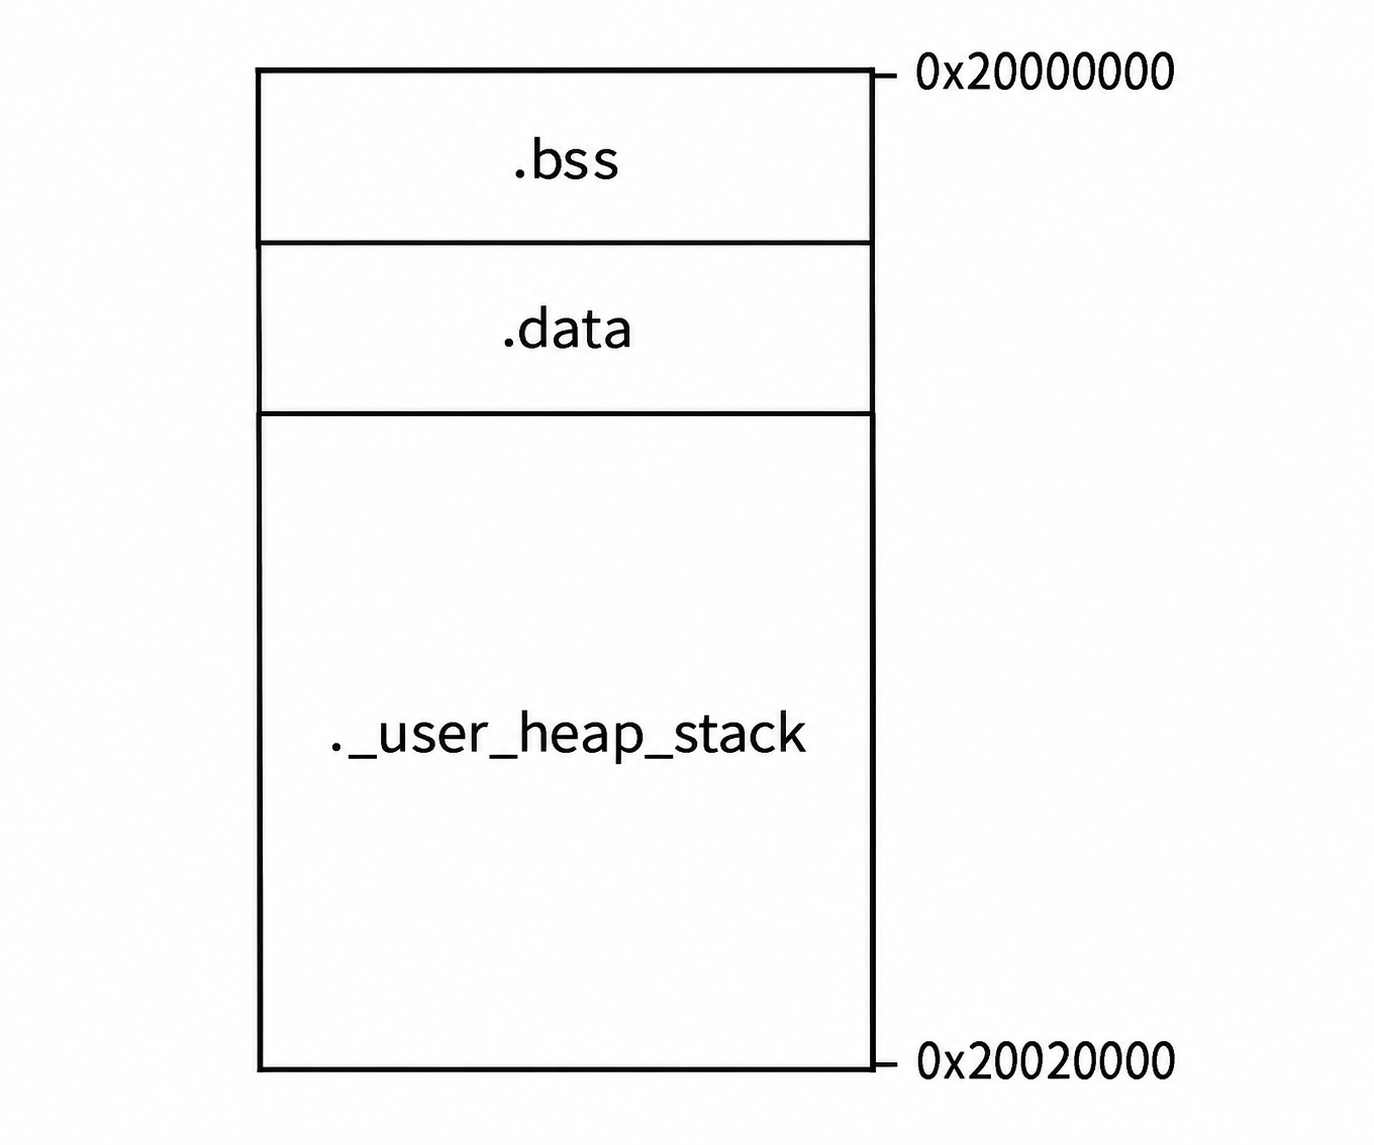
Wiemy już, że stos jako struktura danych nie ma górnego limitu. Im więcej odłożymy danych, tym bardziej rośnie w pamięci. I bazuje na tym, że będziemy na bieżąco zabierać dane, które nie są już potrzebne. Ale to założenie nie zawsze jest prawdziwe. Wtedy mamy do czynienia z przepełnieniem stosu.
Czyli stos rozrasta się do takich rozmiarów, że wchodzi na adresy pamięci przydzielone dla innych sekcji. Najczęściej jest to spowodowane jedną z dwóch przyczyn:
- Zarezerwowaliśmy na stos zbyt mało pamięci i nie może normalnie działać.
- Odkładamy na stos zbyt dużo danych.
W pierwszym przypadku musimy zwiększyć ilość pamięci przydzielonej dla stosu. A jeśli działamy na małym procesorze – być może będziemy musieli zmniejszyć zużycie RAM przez dane lub po prostu przenieść się na model z większą ilością pamięci.
W drugim przypadku musimy sprawdzić, czy nie wywołujemy zbyt wielu zagnieżdżonych funkcji np. rekurencyjnie. Oraz czy nie przekazujemy zbyt dużych argumentów. Właśnie dlatego wszelkiego rodzaju struktury powinniśmy zawsze przekazywać przez wskaźnik. Dzięki temu nasz argument zajmuje 4 bajty potrzebne do przekazania adresu a nie np. 1024 bajty wielkiej struktury konfiguracyjnej.
Kiedy już wiemy, że problemem w naszej aplikacji jest przepełnienie stosu – jesteśmy w stanie dosyć łatwo sobie poradzić. Najgorszą częścią jest zawsze identyfikacja tego problemu.
Co się dzieje po przepełnieniu stosu?
No właśnie tutaj zaczyna się problem, bo nigdy nie wiemy tego na 100%. Aplikacja działa niepoprawnie, ale może objawiać się to na różne sposoby.
Na przykład stos nadpisał dane w RAM innymi wartościami i nasze obliczenia zwracają dziwne wartości. Te wartości są potem przekazywane do kolejnych funkcji, błąd się propaguje i powoduje dziwne zachowanie programu. Stos mógł też nadpisać wskaźniki lub offsety wykorzystywane przy dostępie do danych. Wtedy zaczniemy nadpisywać dane spod zupełnie innych adresów.
Ale błąd może też zadziałać w drugą stronę. Stos wszedł na dane, dana została zaktualizowana i zmodyfikowała adres powrotu z funkcji. Możliwości jest bardzo wiele. W każdym razie program działa dziwnie. Błędy występują w losowych momentach i zdają się nie mieć związku z wykonywaną aktualnie funkcją.
Dlatego przyjmuje się, że przepełnienie stosu powoduje undefined behavior. A najlepsze co aplikacja może zrobić to się zawiesić. Właśnie dlatego chcemy aktywnie wykryć przepełnienie stosu i przenieść sterowanie do nieskończonej pętli w kontrolowany sposób. Zanim kod wykonując się w losowy sposób wywoła jakieś szkody. Z kolei podczas debugowania, kiedy widzimy błędy nie mające na pierwszy rzut oka związku z aktualnie wykonywanym kodem – przepełnienie stosu powinno być jednym z pierwszych podejrzanych.
Metody wykrywania przepełnienia stosu
Jak widzisz – skutki przepełnienia stosu mogą być bardzo niebezpieczne dla naszego programu. Możemy w ten sposób nadpisać nie swoje dane, wywołać nie swoje funkcje. A w przypadku systemów embedded możemy spowodować niewłaściwe działanie silników, drogich maszyn przemysłowych, czy innego krytycznego sprzętu.
Samo debugowanie i usunięcie przepełnień stosu podczas developmentu to za mało. Bardzo często chcemy, aby nasza aplikacja aktywnie broniła nas przed przepełnieniami stosu. Problem jest z nami od wielu lat, dlatego wypracowaliśmy sobie różne techniki obrony. Zarówno od strony programowej, jak i sprzętowej. Teraz zrobimy sobie przegląd popularnych metod obrony przed przepełnieniem stosu.
Memory Management Unit
Duże systemy operacyjne takie jak Windows czy Linux korzystają z pamięci wirtualnej i MMU. Każdy proces przy starcie otrzymuje swoja własną wirtualną przestrzeń adresową, która jest potem mapowanana pamięć fizyczną. Poszczególne strony pamięci mogą mieć dodatkowe atrybuty, np. read, write, execute albo no access. MMU sprawdza te uprawnienia sprzętowo przy każdym dostępie do pamięci.
Pamięć wirtualna pozwala dużo łatwiej odseparować stos od innych obszarów pamięci. System operacyjny definiuje odpowiednie mapowania i prawa dostępu, a MMU jako część procesora egzekwuje je sprzętowo.
Memory Protection Unit
W mikrokontrolerach często nie mamy pełnego MMU z obsługą pamięci wirtualnej, stronicowania itp. Za to często są one wyposażone w prostszy moduł MPU. Pozwala on podzielić fizyczną przestrzeń adresową mikrokontrolera na kilka regionów i przypisać im prawa dostępu, np. read/write/execute/no access. Nie mamy więc wirtualnej pamięci dla każdego procesu, ale nadal możemy sprzętowo ograniczać dostęp do wybranych obszarów pamięci.
Sprzętowe ograniczenia stosu
W nowszych procesorach np. z rodziny ARM Cortex-M33 mamy kolejny sprzętowy mechanizm ochrony przed przepełnienem stosu – sprzętowe ograniczenie adresu. Procesory ARM mają dwa stosy MSP i PSP. Dzięki temu możemy używać osobnego stosu do obsługi przerwań. Każdy z tych stosów ma swój rejestr MSPLIM/PSPLIM przechowujący granicę dozwolonego obszaru stosu – jeżeli stos przekroczy limit, otrzymamy wyjątek.
Programowa detekcja przepełnienia stosu
A co jeśli nie mamy sprzętowego wsparcia wykrywania przepełnienia stosu? No cóż, wtedy musimy radzić sobie odpowiednią obsługą w sofcie. Dobrym przykładem jest tutaj FreeRTOS, który ma porty na wiele procesorów. Jeżeli mamy architekturę CPU wspierającą MPU albo sprzętowe limity stosu – nasz port je wykorzysta. A jeśli nie – możemy bazować na procedurze programowej. Działa ona całkiem prosto i wykorzystuje to, co już wiemy o działaniu stosu. A dokładniej fakt, że gdy dane są zabierane ze stosu modyfikujemy tylko Stack Pointer. Natomiast fizyczne dane w dalszym ciągu znajdują się w tym adresie pamięci. Możemy skorzystać więc z techniki Watermark i zobaczyć, czy poziom zapełnienia stosu dochodzi do maksimum i grozi rozlaniem się na inne dane.
Jak to wygląda w praktyce?
Na końcu danych, które chcemy chronić umieszczamy obszar wypełniony odpowiednim wzorcem np. 0xAAAAAAAA.
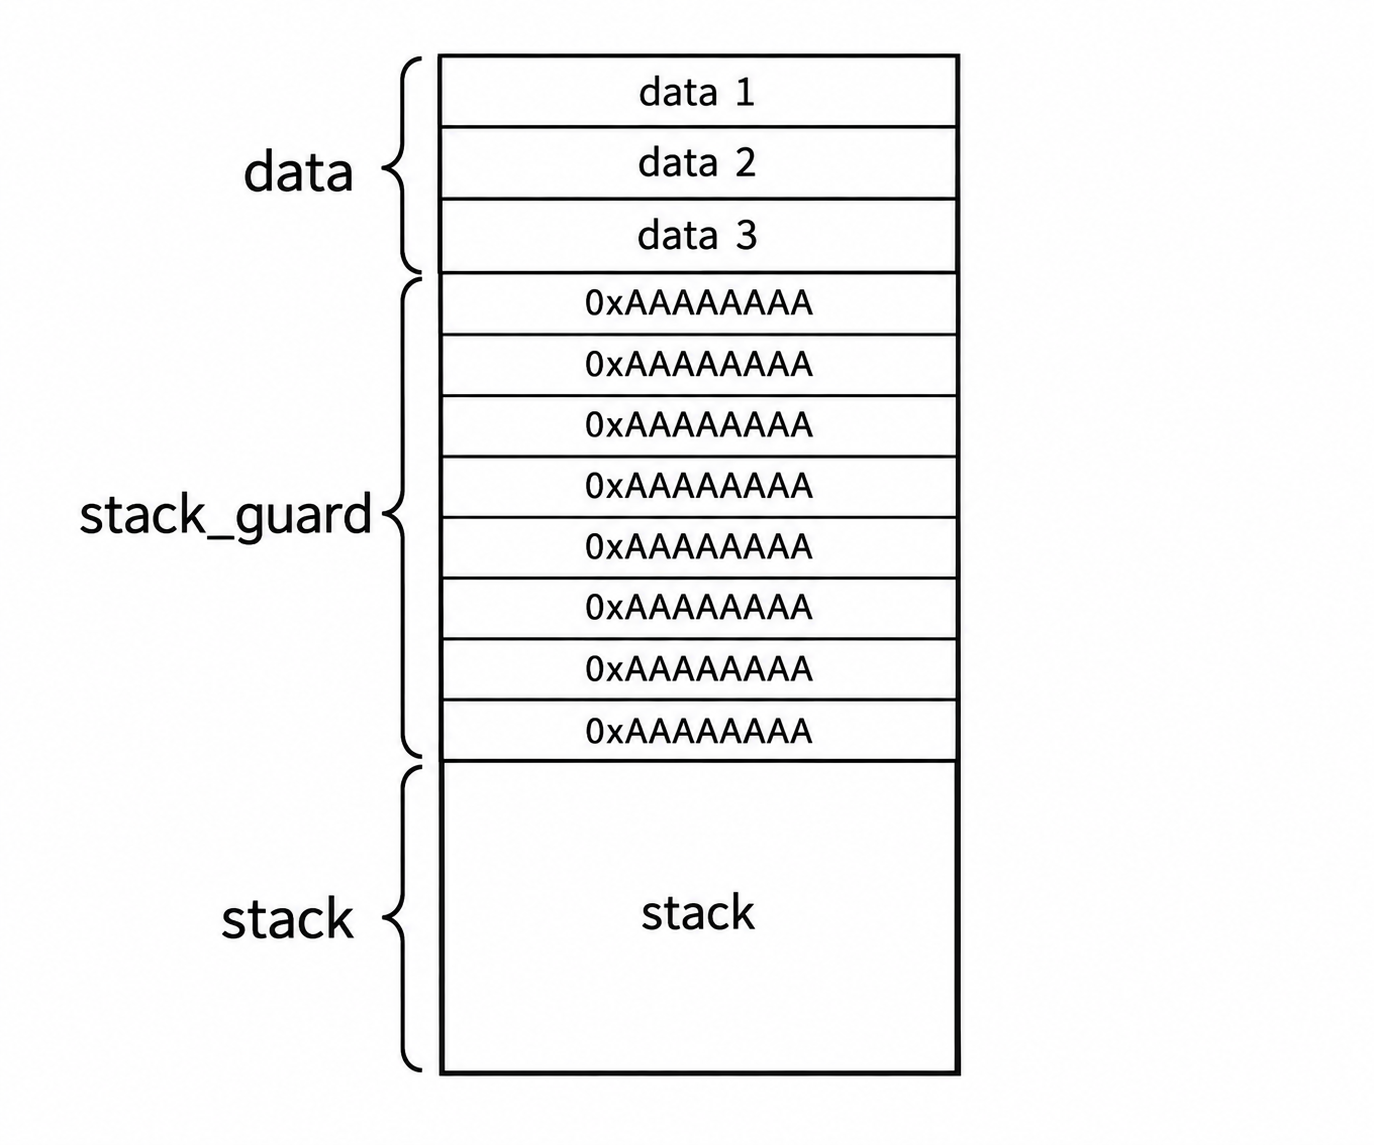
Kiedy stos osiągnie niebezpieczny poziom – zacznie nadpisywać nasz wzorzec
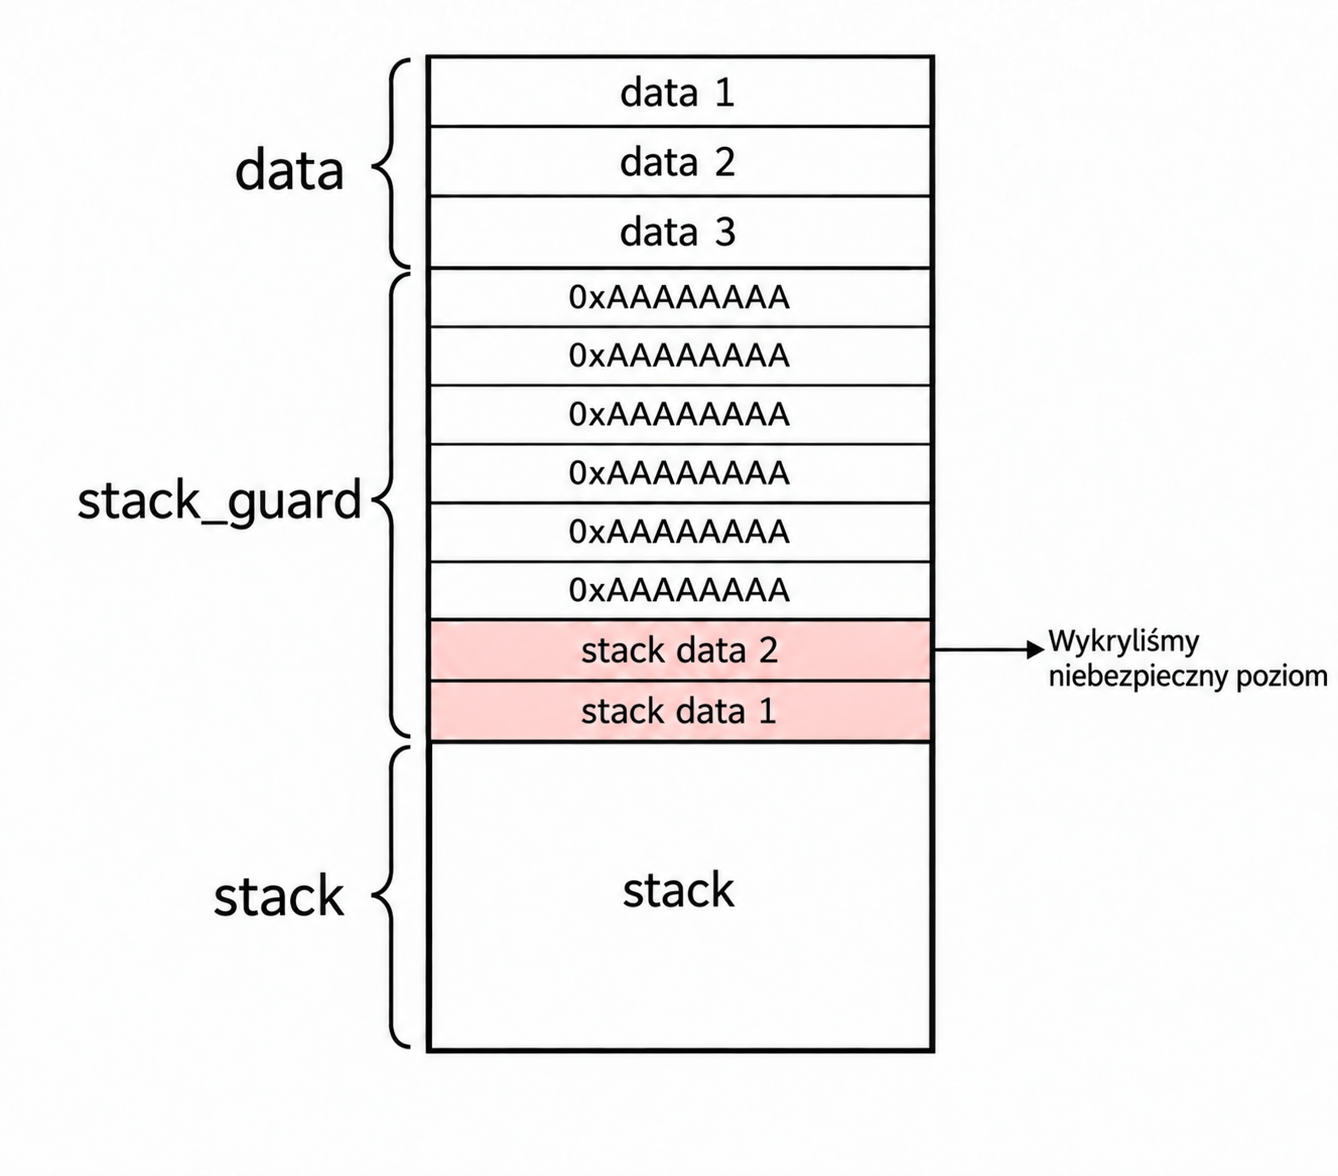
Musimy więc cyklicznie odczytywać nasz region wypełniony wzorcem i sprawdzać, czy nie został nadpisany. Po wykryciu wysokiego poziomu stosu – przechodzimy do stanu bezpiecznego zanim przepełnienie stosu wyrzadzi jakiekolwiek szkody w naszym systemie.
Warto tutaj jeszcze zwrócić uwagę na kilka rzeczy – Po pierwsze RTOS działa w oparciu o wiele tasków. Każdy z nich ma oddzielny stos. A każdy z tych stosów ma oddzielny watermark. czyli procedura wykrywania przepełnienia uwzględnia jeszcze różne działające taski.
Po drugie ta procedura nigdy nie będzie tak dobra jak wsparcie sprzętowe. Nie dostaniemy wyjątku od razu w momencie dostępu przez stos do pamięci na dane. Po prostu cyklicznie sprawdzamy nasze znaczniki i liczymy, że uda się wykryć potencjalny problem zanim się wydarzy. Tak więc rozmiar naszego regionu ochronnego jak i częstotliwość sprawdzania mają realny wpływ na prawdopodobieństwo wykrycia przepełnienia przed uszkodzeniem danych. Także ta procedura jest pomocna, ale nie daje gwarancji.
A co jeśli chcemy dodać wykrywanie przepełnienia stosu w naszym projekcie?
Oczywiście jeśli mamy dostęp do sprzętowych metod ochrony stosu – powinniśmy z nich korzystać. Są one dużo pewniejsze i dają informację od razu w momencie zdarzenia. Jednak wsparcie sprzętowe różni się między procesorami, poza tym nie każdy mikrokontroler je posiada. Dlatego w dalszej części artykułu przedstawię sposób programowy.
Stack Guard na STM32 – implementacja krok po kroku
Do wykrywania przepełnienia stosu będziemy potrzebować:
- specjalnej sekcji wyjściowej w RAM
- procedury inicjalizacyjnej
- procedury sprawdzającej naruszenie granicy
Przykład przygotowałem dla STM32F411RE, korzystając z GNU Linkera i projektu wygenerowanego w STM32CubeIDE. Zmodyfikujemy skrypt linkera, dodamy osobny moduł C i wywołamy inicjalizację z procedury startowej.
Zaczynamy od linkera. Domyślny skrypt umieszcza w RAM:
- bss – zmienne statyczne inicjalizowane zerami
- data – zmienne statyczne inicjalizowane innymi wartościami
- RamFunc – część data, kod do wywoływania z RAM
- user_heap_stack – czyli stos i dynamiczna alokacja pamięci
Do tego deklaruje kilka przydatnych symboli:
/* Highest address of the user mode stack */
_estack = ORIGIN(RAM) + LENGTH(RAM); /* end of "RAM" Ram type memory */
_Min_Heap_Size = 0x200; /* required amount of heap */
_Min_Stack_Size = 0x400; /* required amount of stack */
Widzimy więc tutaj, że za danymi w pamięci mamy jedną sekcję obsługującą jednocześnie stos i dynamiczną alokację. Zobaczmy sobie teraz dokładniej jej zawartość:
 ._user_heap_stack :
 {
   . = ALIGN(8);
   PROVIDE ( end = . );
   PROVIDE ( _end = . );
   . = . + _Min_Heap_Size;
   . = . + _Min_Stack_Size;
   . = ALIGN(8);
 } >RAM
Tutaj mamy zadeklarowany symbol `.end` oznaczający koniec danych. Następnie dodany jest minimalny rozmiar heapa i minimalny rozmiar stosu. Wygląda więc na to, że stos zaczyna się od ostatniego adresu w pamięci i rośnie w kierunku niższych adresów. Z kolei heap zaczyna się zaraz za danymi i rośnie w kierunku końca pamięci. Możemy to jeszcze potwierdzić sprawdzając plik sysmem.c i implementację _sbrk czyli syscalla obsługującego dynamiczną alokację pamięci:
void *_sbrk(ptrdiff_t incr)
{
 extern uint8_t _end; /* Symbol defined in the linker script */
 extern uint8_t _estack; /* Symbol defined in the linker script */
 extern uint32_t _Min_Stack_Size; /* Symbol defined in the linker script */
 const uint32_t stack_limit = (uint32_t)&_estack - (uint32_t)&_Min_Stack_Size;
 const uint8_t *max_heap = (uint8_t *)stack_limit;


 /* Initialize heap end at first call */
 if (NULL == __sbrk_heap_end)
 {
   __sbrk_heap_end = &_end;
 }
 /* Protect heap from growing into the reserved MSP stack */
 if (__sbrk_heap_end + incr > max_heap)
 {
   errno = ENOMEM;
   return (void *)-1;
 }
Widzimy tutaj, że zmienna stack limit oznacza granicę między stosem a heapem i jeżeli heap chciałby ją przekroczyć – otrzymamy błąd ENOMEM. Znamy już więc dokładny rozkład pamięci RAM:
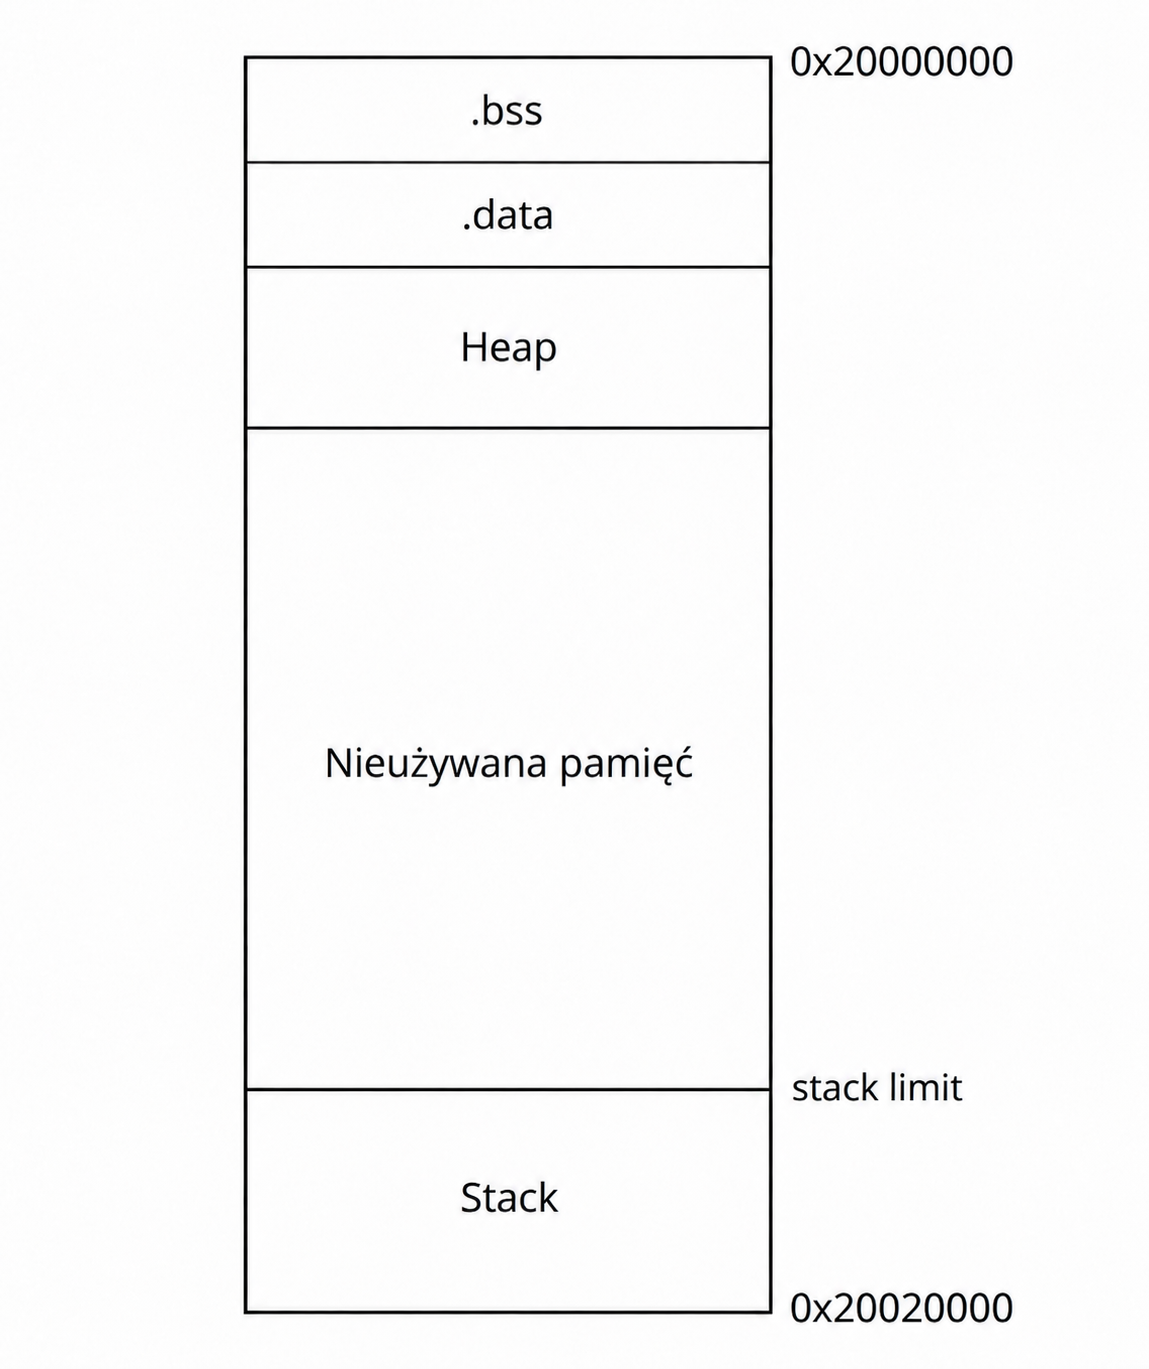
Teraz pytanie w jaki sposób chcemy zorganizować naszą ochronę przed przepełnieniem stosu. Ta dynamiczna alokacja trochę nam psuje. A to dlatego, że mamy teraz dwa elementy o zmiennym rozmiarze – stos i heap. I oba rosną w przeciwnych kierunkach wykorzystując ten sam blok pustej pamięci pomiędzy nimi.
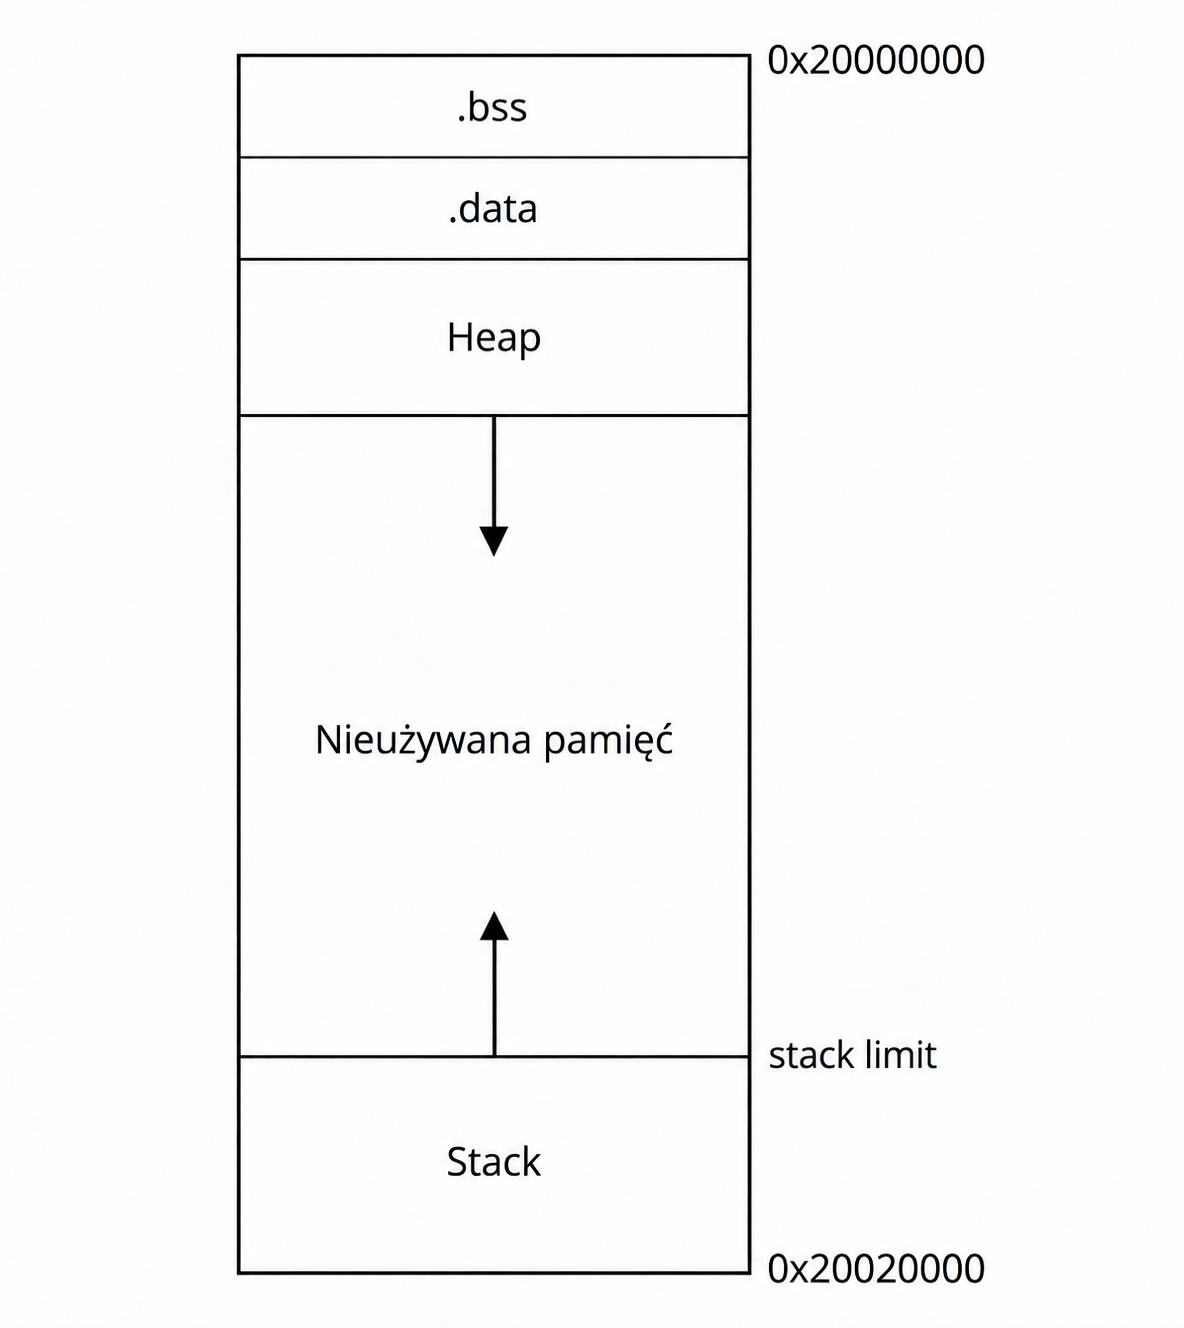
Ogólnie takie rozwiązanie heapu i stosu jest dobre. Nie musimy z góry zakładać, czy nasza aplikacja zużyje więcej wolnego miejsca na dynamiczną alokację, czy stos. Mają całe pozostałe wolne miejsce na spółę. Jednak kiedy chcemy dodać ochronę stosu – sprawa się komplikuje. Żeby sprawdzić, czy przekroczyliśmy rozmiar stosu, musimy wiedzieć, gdzie jest jego granica. Mamy tutaj kilka opcji.
- Chronimy tylko dane statyczne
Możemy zrobić ochronę stosu za sekcją data. Wtedy stos najpierw przepełnia swój zakres, potem nadpisuje całą pamięć zaalokowaną dynamicznie i dochodzi do danych. Nie brzmi to zbyt bezpiecznie – w końcu nadpisanie dynamicznych danych też może spowodować błędy.
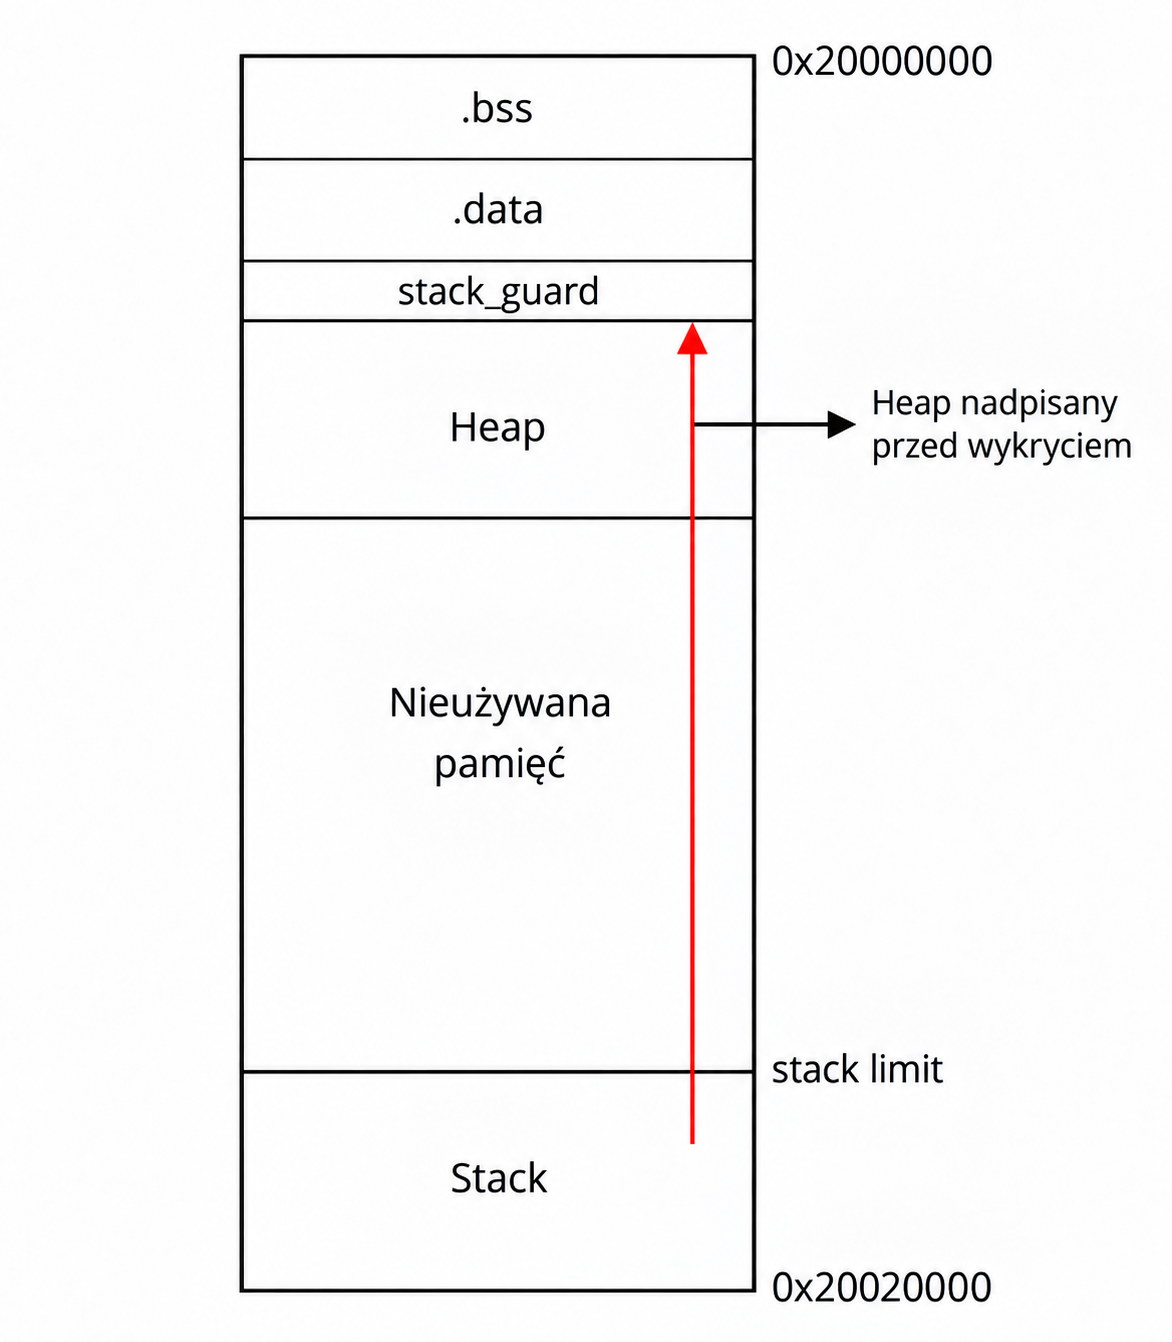
Ale z drugiej strony bardzo często nie używamy dynamicznej alokacji w naszym projekcie i w praktyce cała pozostała pamięć jest przeznaczona na stos. Wtedy wszystko jest w porządku.
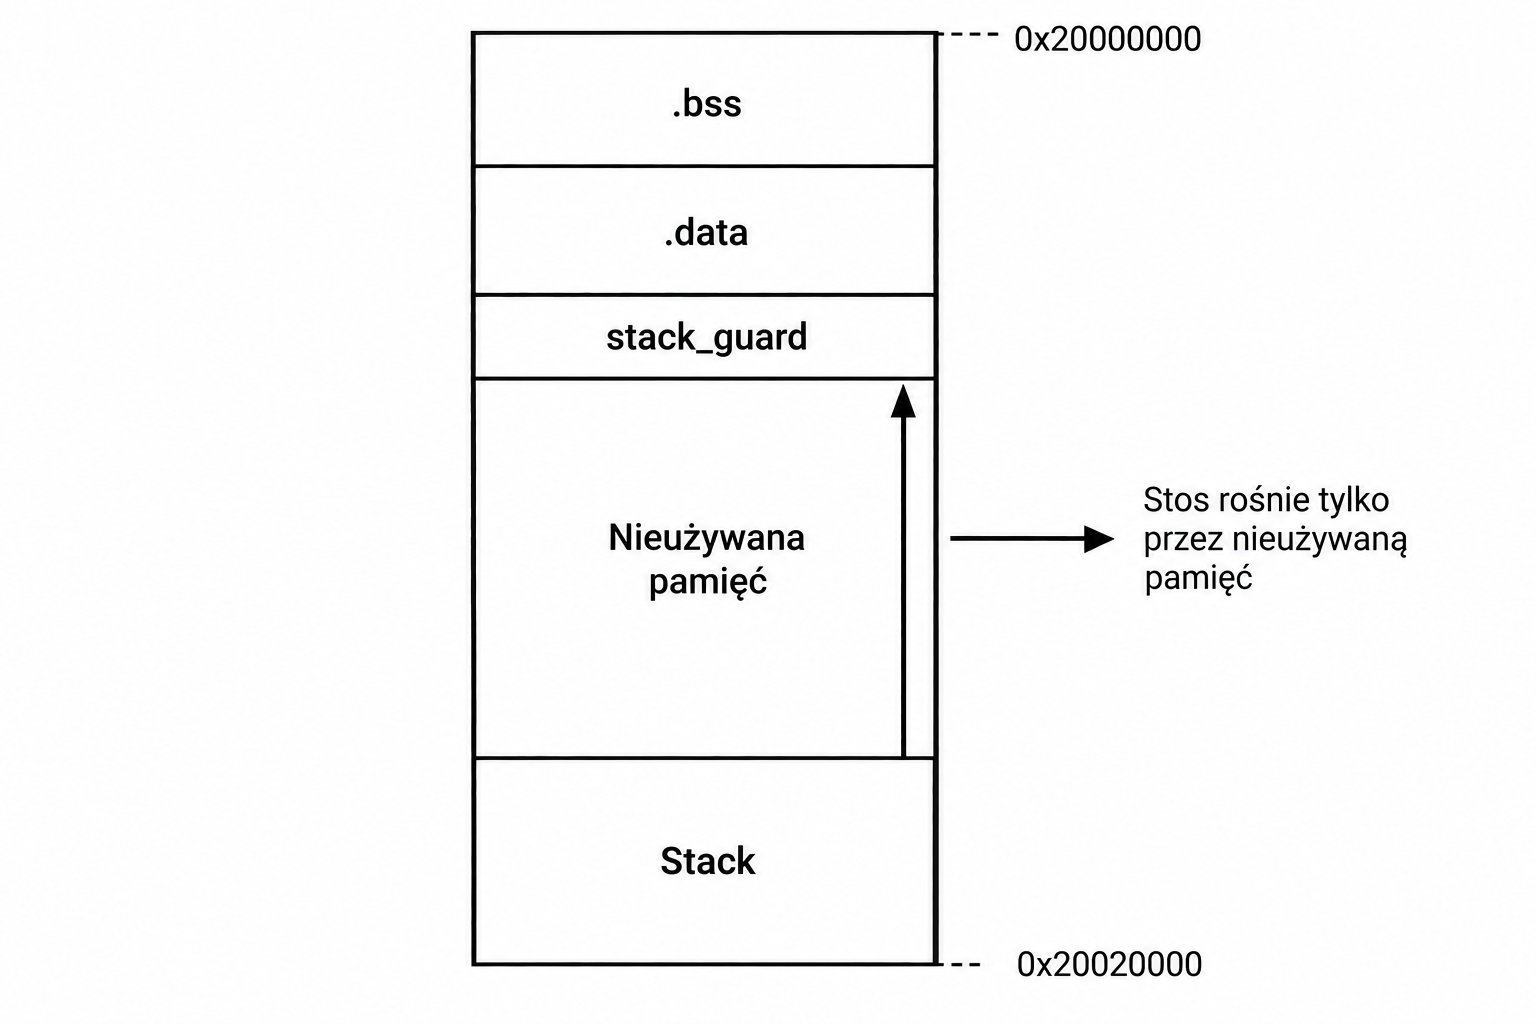
- Ustawiamy ochronę między heapem a stosem
Czyli z góry ustalamy rozmiar stosu i powyżej dodajemy ochronę przed przepełnieniem. W ten sposób dynamicznie alokowana pamięć również jest chroniona. Nic w ten sposób nie tracimy, bo startowa implementacja i tak przeznaczała na dynamiczną alokację całą pamięć poza jawnie zdefiniowanym rozmiarem stosu.
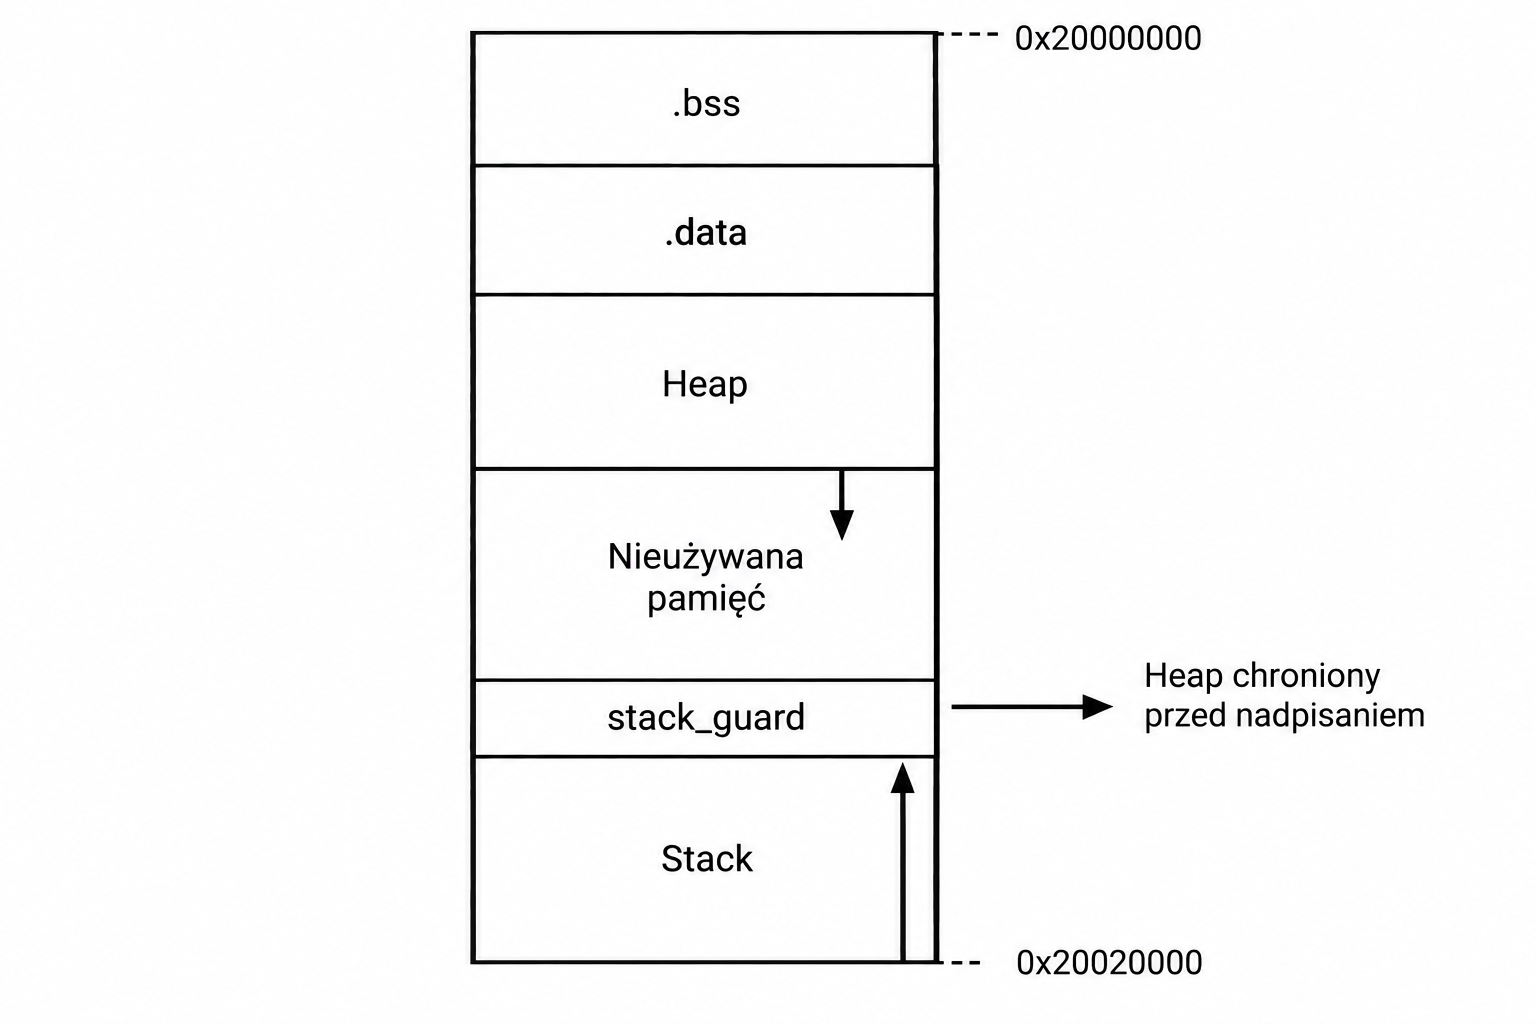
- Zmiana położenia stosu i heapa
Możemy też umieścić stos w innym miejscu pamięci. Na przykład stos znajdzie się po danych statycznych i rośnie w ich stronę, a heap zaczyna się z dalszego adresu i rośnie do końca pamięci. Musimy wtedy również odpowiednio zmodyfikować funkcję sbrk i warunek sprawdzający wejście na pamięć stosu.
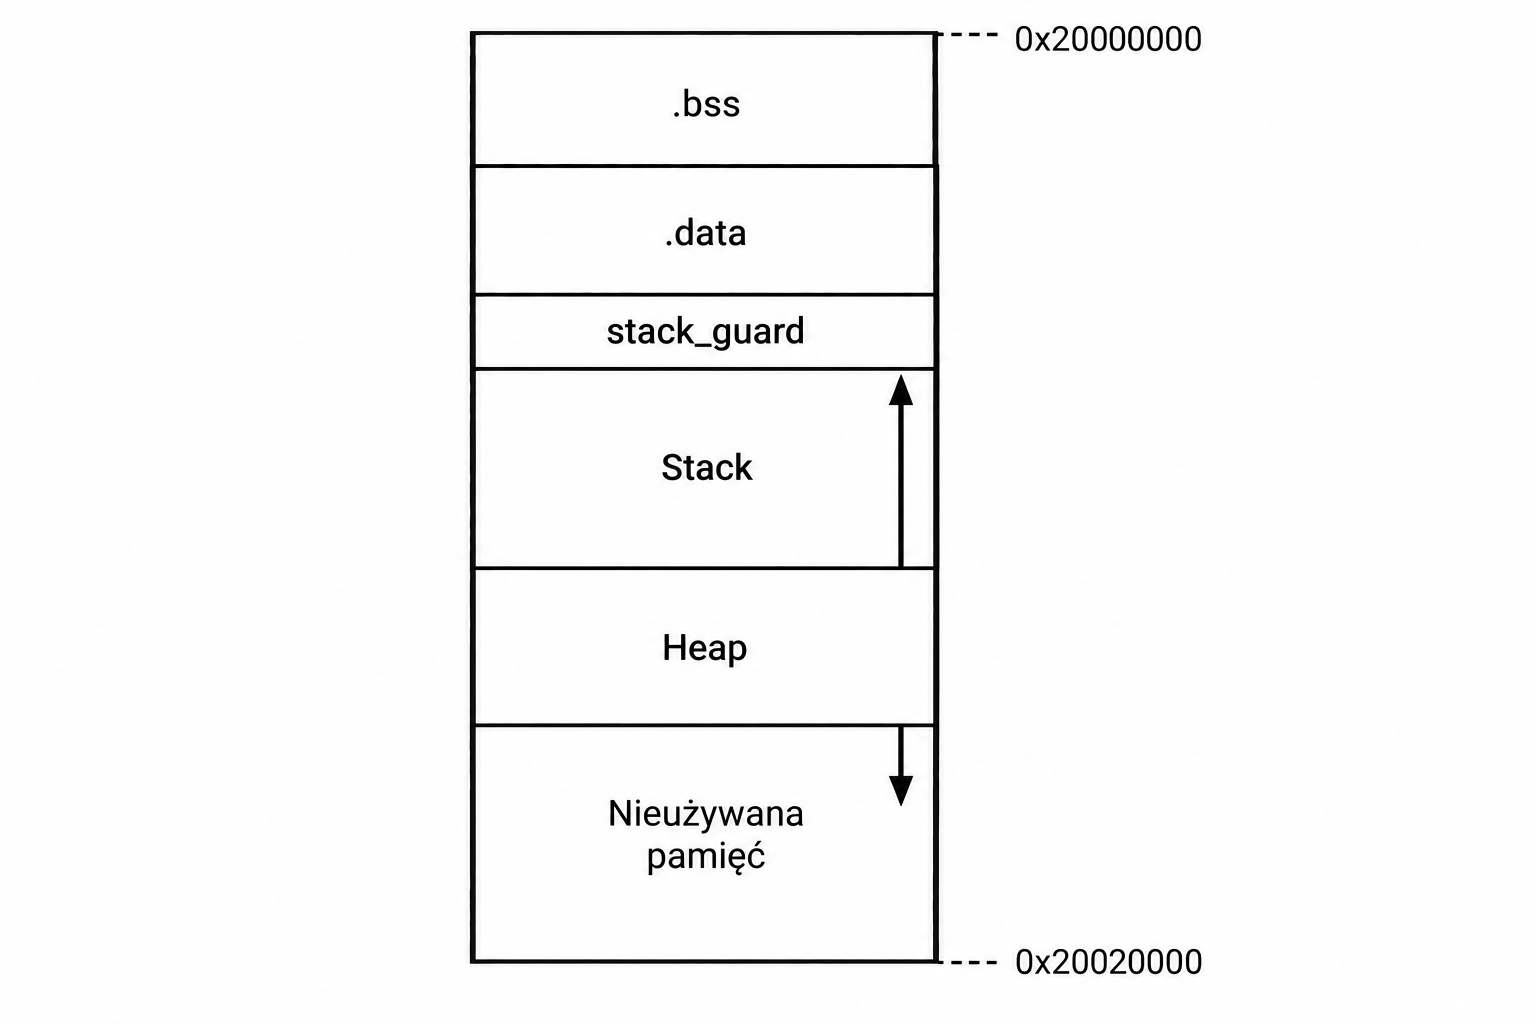
Jak widać – dynamiczna alokacja pamięci dodaje nam kolejną decyzję projektową. Tak samo jeżeli mamy jakiekolwiek inne dodatkowe sekcje w pamięci. Musimy wiedzieć jak są względem siebie ułożone i czy potrzebują protekcji, bo stos może rosnąć w ich stronę.
My sobie założymy najprostszy przypadek. Czyli nie używamy w ogóle dynamicznej alokacji. Wtedy możemy skorzystać z wariantu 1. Natomiast definicje heapa i sysmem mogą sobie zostać w projekcie. W ten sposób będzie prościej wytłumaczyć implementację. A samo położenie ochrony stosu w pamięci jest już proste do zmiany.
Modyfikacja skryptu linkera
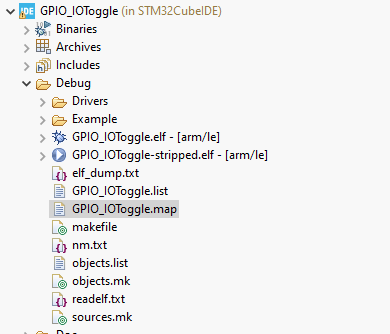
Wiemy już co gdzie się znajduje w bazowym skrypcie. Wiemy też, co chcemy osiągnąć. Zostało nam tylko zmodyfikować skrypt. W skryptach GNU Linkera sekcje są umieszczane w pamięci w tej samej kolejności, co w tekście skryptu. Czyli jeżeli u nas najpierw jest bss, a potem data – tak samo będzie w RAMie. Możemy to sprawdzić w pliku .map, który znajdziemy w folderze ze skompilowanymi artefaktami:
*(.bss)
.bss           0x20000000       0x1c
*(.bss*)
.bss.uwTick    0x20000000        0x4 ./Drivers/STM32F4xx_HAL_Driver/stm32f4xx_hal.o
               0x20000000                uwTick
.bss.GPIO_InitStruct
               0x20000004       0x14 ./Example/User/main.o
.bss.config    0x20000018     0x04 ./Example/User/main.o
…


.data           0x2000001c       0x30 load address 0x0800d740
               0x2000001c                        . = ALIGN (0x4)
               0x2000001c                        _sdata = .
*(.data)
*(.data*)
.data.SystemCoreClock
               0x2000001c        0x4 ./Drivers/CMSIS/system_stm32f4xx.o
               0x2000001c                SystemCoreClock
Widzimy tutaj sekcje, adresy i rozmiary zaalokowane na poszczególne obiekty. Widzimy, że bss jest przed data. Jak byśmy mieli jakieś dodatkowe własne sekcje w ramie – możemy tutaj dokładnie sprawdzić ich ułożenie w pliku wynikowym.
Czyli naszego stack guarda dodamy po sekcji data. Nie będziemy chcieli tam dawać żadnych danych z plików C, będziemy chcieli tylko zaalokować odpowiedni rozmiar sekcji. W tym celu posłuży nam następujący kod:
_Stack_Guard_Size = 128;


 .stack_guard :
 {
   PROVIDE(_stack_guard_start = .);
 	. = ALIGN(4);

 	. += _Stack_Guard_Size;

 	. = ALIGN(4);
 	PROVIDE(_stack_guard_end = .);
 } >RAM
Czyli deklarujemy rozmiar stack guarda na 128 bajtów. Następnie tworzymy sekcję wyjściową o nazwie `.stack_guard` i alokujemy ją w RAMie (odpowiada za to `>RAM` na końcu).
Wewnątrz definicji sekcji tworzymy symbole, które potem nam się przydadzą do obsługi w kodzie – _stack_guard_start / stack_guard_end. Oraz alokujemy odpowiednią ilość bajtów wewnątrz naszej sekcji za pomocą:
. += _Stack_Guard_Size;I to wszystko. Możemy skompilować od nowa projekt i zobaczymy nową sekcję w pliku map:
.stack_guard    0x20000064       0x80 load address 0x0800d770
               0x20000064                        PROVIDE (_stack_guard_start = .)
               0x20000064                        . = ALIGN (0x4)
               0x200000e4                        . = (. + _Stack_Guard_Size)
*fill*         0x20000064       0x80
               0x200000e4                        . = ALIGN (0x4)
               [!provide]                        PROVIDE (_stack_guard_end = .)
Widzimy tutaj, że poprawnie zaalokowało się 0x80 czyli 128 bajtów. Teraz pozostaje nam obsłużyć ochronę stosu w kodzie.
Procedura inicjalizacyjna
Inicjalizacja naszego stack guarda będzie wołana w startupie przed wejściem do funkcji main. Startup w projekcie Cube jest wygenerowany w asemblerze, ale to nie oznacza, że nasza inicjalizacja też musi. Możemy zamiast tego napisać inicjalizację w C, a w asemblerze tylko wywołać odpowiednią funkcję.
W tym celu robimy moduł stack_guard.c i umieszczamy w nim funkcję:
void stack_guard_init(void)Będziemy też potrzebować symboli _stack_guard_start/end wygenerowanych przez skrypt linkera. Ich deklaracja w C jest nieco pokrętna. A to dlatego, że linker używa pewnych brudnych hacków, żeby dodać te symbole i na tym etapie może jedynie modyfikować wartości interpretowane przez C jako adresy. Dlatego w kodzie musimy wziąć adres naszego symbolu i przepisać go do docelowej zmiennej.
#define STACK_GUARD_PATTERN 0xAAAAAAAA

extern uint32_t _stack_guard_start;
extern uint32_t _stack_guard_end;
extern uint32_t _Stack_Guard_Size;

void stack_guard_init(void)
{
	uint32_t *ptr = &_stack_guard_start;
	int size = (int)&_Stack_Guard_Size;

	for (int i = 0; i < size; i += 4)
	{
		*ptr++ = STACK_GUARD_PATTERN;
	}
}
Jak widzisz pod względem logiki nasza inicjalizacja jest prosta – robimy pętle wypełniającą naszego stack guarda znanym wzorcem.
Teraz musimy wywołać funkcję inicjalizacyjną w startupie. W tym celu do procedury asemblerowej dodajemy:
/* Call the clock system initialization function.*/
 bl  SystemInit
/* Call static constructors */
   bl __libc_init_array
/* Kod powyżej już był w skrypcie */

 bl stack_guard_init

/* Kod poniżej już był w skrypcie */
/* Call the application's entry point.*/
 bl  main
 bx  lr
Czyli dodajemy w asemblerze skok do naszej funkcji. Nie musimy deklarować żadnych symboli, kompilator powinien zobaczyć odpowiednią funkcję i ją wywołać. Możemy to prześledzić na debugu – w startupie można wstawiać breakpointy mimo, że wywołuje się przed funkcją main.
I w ten sposób mamy pełną inicjalizację. Przed wejściem do maina wywołuje się funkcja inicjalizacyjna i wypełnia blok ochrony stosu znanymi wartościami. Zostało nam już tylko wykrywanie przepełnienia.
Wykrywanie naruszenia stosu
To będzie kolejna pętla. Tym razem przechodzimy po całym bloku ochrony stosu i sprawdzamy, czy wartość jest ta sama, co wpisana w inicjalizacji. Jeśli nie – stos się przepełnił i powinniśmy przejść do safe state czyli w naszym przypadku do nieskończonej pętli. Cały kod wygląda następująco:
static void safe_state(void)
{
	while (1)
		;
}

void stack_guard_check(void)
{
	uint32_t *ptr = &_stack_guard_start;
	int size = (int)&_Stack_Guard_Size;

	for (int i = 0; i < size; i += 4)
	{
		if (*ptr++ != STACK_GUARD_PATTERN)
		{
			safe_state();
		}
	}
}
Musimy jeszcze cyklicznie wywoływać naszą funkcję sprawdzającą podczas działania programu. Możemy to robić w jakimś tasku diagnostycznym w równych odstępach czasu.
A jeśli chcemy sprawdzić, czy nasza procedura działa – możemy w debugu użyć zakładki memory i zmodyfikować sekcję stack guarda. Kod powinien wykryć błąd i wejść do nieskończonej pętli.
Podsumowanie
W tym artykule omówiliśmy sobie działanie stosu na mikrokontrolerze, jak powstaje przepełnienie, jak je identyfikować i w jaki sposób się przed nim bronić. Następnie stworzyliśmy własną implementację wykrywania przepełnienia stosu bazującą w pełni na skryptach GNU Linkera oraz obsłudze programowej. Dzięki temu możemy wykorzystać to rozwiązanie praktycznie w każdym mikrokontrolerze. A jeżeli potrzebujemy bardziej zaawansowanej ochrony – możemy skorzystać z procesora zawierającego lepszy poziom ochrony np. Cortex-M33.
W tym artykule skupiłem się na mechanizmu działania stosu i jego ochrony. Nie chciałem wchodzić w szczegóły działania procesora, składni skryptów linkera czy plików map. Jeżeli chcesz pogłębić swą wiedzę w tych tematach – koniecznie sprawdź moje kursy:
Asembler w Embedded – https://ucgosu.pl/asembler
Linker w Embedded – https://ucgosu.pl/linker/
Możesz również zobaczyć nagranie z Live na YouTube, gdzie podobny mechanizm implementowałem na żywo:
Źródła
FreeRTOS – procedura wykrywania przepełnienia stosu:
https://1.freertos.org/Documentation/02-Kernel/02-Kernel-features/09-Memory-management/02-Stack-usage-and-stack-overflow-checking
Dokumentacja GNU Linkera:
https://sourceware.org/binutils/docs/ld/
Autor: Maciej Gajdzica